IA et Technologie

Comment traduire un PDF numérisé avec l'OCR

sept. 21, 2026

Comment traduire un PDF numérisé avec l'OCR

Le problème des PDF numérisés

Lorsque vous numérisez un document papier et l'enregistrez en PDF, le fichier ne contient qu'une image de la page — aucun texte sélectionnable ni copiable. Les outils de traduction habituels échouent complètement car il n'y a rien à traduire : le texte n'existe qu'en pixels.

Cela concerne une grande variété de documents : contrats notariés, certificats officiels, archives historiques, télécopies imprimées et tout document arrivé sous forme papier puis numérisé.

Comment fonctionne OCR + traduction IA

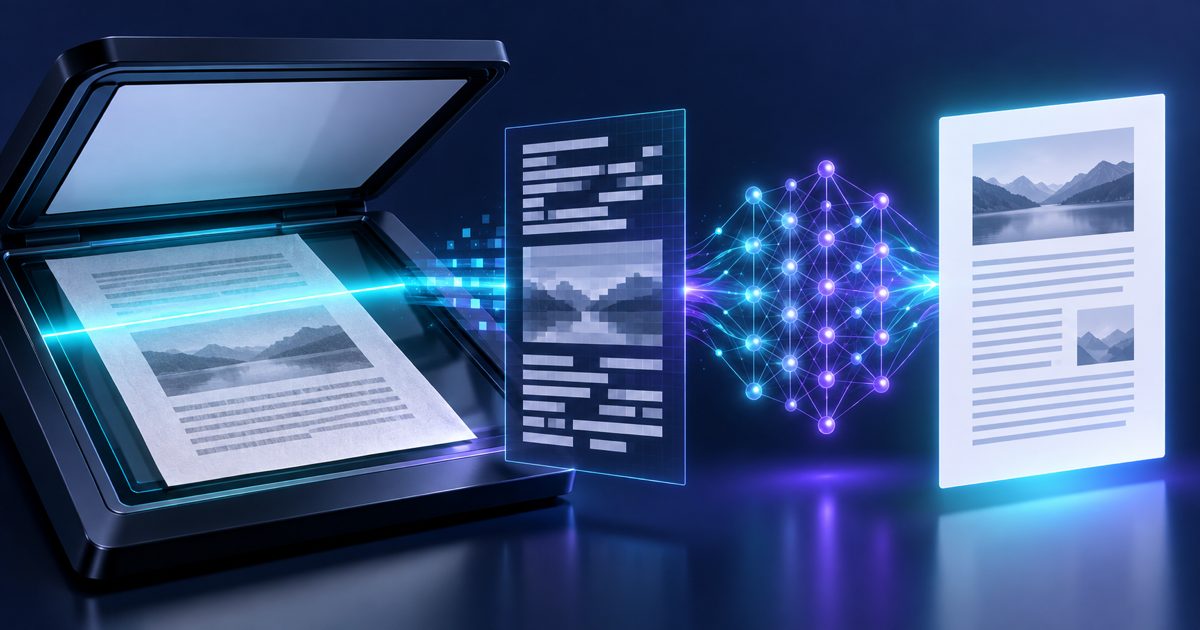
La solution repose sur un traitement en deux temps : reconnaissance optique de caractères (OCR), puis traduction automatique neuronale.

  1. Analyse OCR — le moteur analyse chaque page pixel par pixel, identifie les formes des caractères et reconstruit la couche de texte.
  2. Détection de la mise en page — colonnes, tableaux, en-têtes et pieds de page sont identifiés et cartographiés.
  3. Extraction de texte — le texte reconstruit est nettoyé : artefacts de tirets, bruit de saut de ligne et imperfections de numérisation sont corrigés.
  4. Traduction IA — le texte propre est passé à un modèle de traduction neuronale ajusté pour le contexte documentaire.
  5. Reconstruction du format — le texte traduit est disposé dans la structure originale et exporté en PDF.

Exigences de qualité d'image

La précision de l'OCR dépend directement de la qualité du scan. Les meilleures conditions sont les suivantes :

  • Résolution — 300 DPI ou plus. En dessous de 100 DPI, la précision chute fortement.
  • Orientation — les pages doivent être droites. La correction automatique de l'inclinaison fonctionne jusqu'à ~10°.
  • Contraste — texte sombre sur fond clair. L'encre délavée ou les fonds colorés réduisent la précision.
  • Pas d'écriture manuscrite — le texte imprimé est reconnu avec haute précision ; les annotations manuscrites sont extraites où lisibles.
  • Format de fichier — PDF, JPG, PNG et TIFF sont acceptés.
100+Scripts OCR
100+Langues cibles
300DPI recommandés

Étape par étape : traduire votre PDF numérisé

  1. Téléchargez le PDF numérisé — le système détecte automatiquement qu'il s'agit d'un document basé sur une image.
  2. Sélectionnez la langue source (optionnel) — la détection automatique fonctionne pour la plupart des scripts.
  3. Sélectionnez la langue cible — plus de 100 langues disponibles.
  4. L'OCR extrait le texte — un aperçu du contenu reconnu est affiché.
  5. L'IA traduit — le texte extrait est traduit avec tout le contexte documentaire préservé.
  6. Téléchargez le PDF traduit — le fichier de sortie conserve les mêmes dimensions et colonnes que le scan original.

Types de documents numérisés les plus fréquents

  • Contrats notariés — documents signés et tamponnés qu'on ne peut pas ressaisir sans perdre leur authenticité
  • Actes officiels — actes de naissance et de mariage, diplômes et titres professionnels délivrés par des organismes publics
  • Pièces de procédure et archives judiciaires — dossiers anciens et jugements archivés
  • Dossiers médicaux — dossiers patients, résultats de laboratoire et lettres d'adressage issus de systèmes anciens
  • États financiers — relevés bancaires et rapports d'audit imprimés avant l'archivage numérique
  • Manuels techniques — documentation produit de fabricants n'ayant fourni que des exemplaires papier
Que se passe-t-il si le document numérisé est à l'envers ou pivoté ?

Le moteur OCR applique une détection automatique de l'orientation et corrige les rotations de 0°, 90°, 180° et 270°. L'inclinaison modérée (moins de 10°) est également corrigée automatiquement.

Peut-il gérer des documents avec tampons et filigranes ?

Oui. L'OCR filtre la plupart des filigranes standards (texte diagonal clair) et les tampons ronds dans les marges. Le texte se superposant directement à un tampon sombre peut avoir une précision réduite dans cette zone.

Le scan original est-il conservé dans le fichier de sortie ?

Le résultat est un PDF textuel avec le contenu traduit dans le même layout. L'image du scan n'est pas incorporée — cela garde le fichier léger et le texte consultable.

Traduisez votre PDF numérisé maintenant

Téléchargez n'importe quel document numérisé et laissez OCR + IA faire le reste. Sans saisie, sans copier-coller.

Traduire un PDF numérisé