KI & Technologie

Gescannte PDF mit OCR übersetzen

Sep 21, 2026

Gescannte PDF mit OCR übersetzen

Das Problem mit gescannten PDFs

Wenn Sie ein Papierdokument scannen und als PDF speichern, enthält die Datei nur ein Bild der Seite — keinen auswählbaren oder kopierbaren Text. Normale Übersetzungstools scheitern vollständig, weil es nichts zu übersetzen gibt: Der Text existiert nur als Pixel.

Dies betrifft eine Vielzahl von Dokumenten: notariell beglaubigte Verträge, von Behörden ausgestellte Zertifikate, historische Aufzeichnungen, Faxausdrucke und alle Dokumente, die als Papier ankamen und dann digitalisiert wurden.

Wie OCR + KI-Übersetzung funktioniert

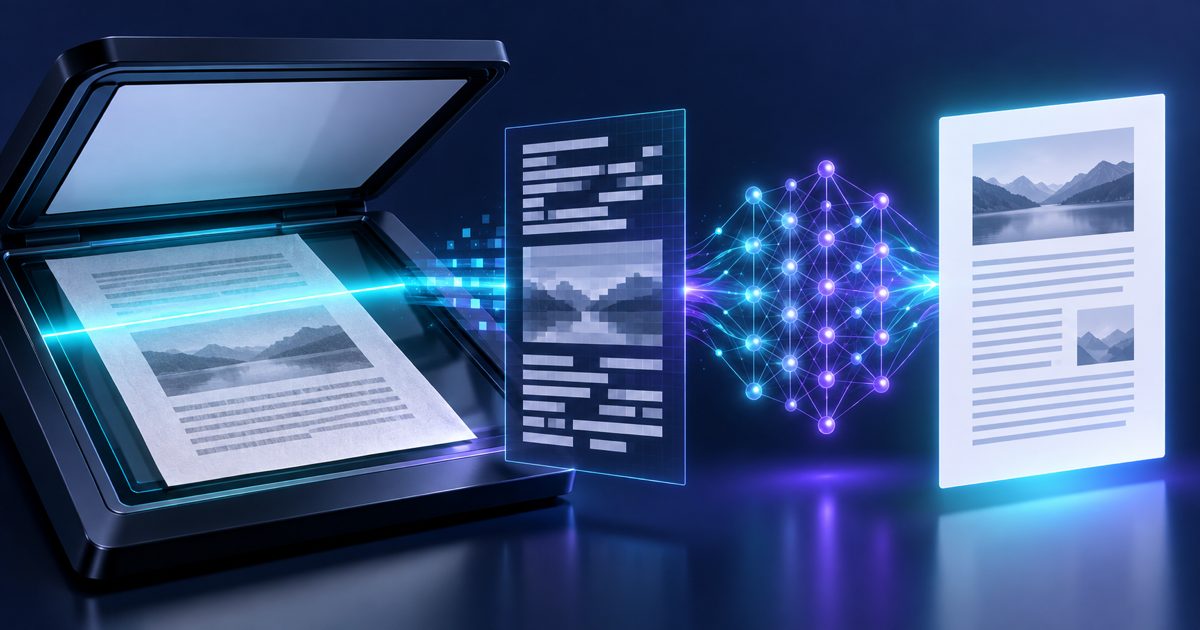
Die Lösung ist eine zweistufige Verarbeitung: optische Zeichenerkennung (OCR) und anschließend neuronale maschinelle Übersetzung.

  1. OCR-Analyse — die Engine scannt jede Seite Pixel für Pixel, erkennt Zeichenformen und rekonstruiert die Textebene.
  2. Layout-Erkennung — Spalten, Tabellen, Kopf- und Fußzeilen werden identifiziert und zugeordnet.
  3. Textextraktion — der rekonstruierte Text wird bereinigt: Trennzeichen-Artefakte und Scan-Unvollkommenheiten werden vor der Übersetzung korrigiert.
  4. KI-Übersetzung — der bereinigte Text wird an ein auf Dokumentenkontext optimiertes neuronales Übersetzungsmodell übergeben.
  5. Formatrekonstruktion — der übersetzte Text wird im Original-Dokumentenlayout platziert und als PDF exportiert.

Bildqualitätsanforderungen

Die OCR-Genauigkeit hängt unmittelbar von der Scanqualität ab. Unter diesen Bedingungen sind die Ergebnisse am besten:

  • Auflösung — 300 DPI oder höher. Unter 100 DPI sinkt die Genauigkeit stark.
  • Ausrichtung — Seiten sollten gerade sein. Automatische Schräglaufkorrektur funktioniert bis ca. 10°.
  • Kontrast — dunkler Text auf hellem Hintergrund. Verblasste Tinte oder farbige Hintergründe reduzieren die Genauigkeit.
  • Kein Handgeschriebenes — gedruckter Text wird mit hoher Genauigkeit erkannt; handschriftliche Anmerkungen werden wo lesbar extrahiert.
  • Dateiformat — PDF, JPG, PNG und TIFF werden akzeptiert.
100+OCR-Skripte
100+Zielsprachen
300DPI empfohlen

Schritt für Schritt: Gescanntes PDF übersetzen

  1. Gescanntes PDF hochladen — das System erkennt automatisch, dass es sich um ein bildbasiertes Dokument handelt.
  2. Quellsprache auswählen (optional) — automatische Erkennung funktioniert für die meisten Skripte.
  3. Zielsprache auswählen — über 100 Sprachen verfügbar.
  4. OCR extrahiert Text — eine Vorschau des erkannten Inhalts wird angezeigt.
  5. KI übersetzt — der extrahierte Text wird mit vollständigem Dokumentenkontext übersetzt.
  6. Übersetztes PDF herunterladen — die Ausgabedatei behält dieselben Seitenabmessungen und Spalten wie der ursprüngliche Scan.

Häufig gescannte Dokumenttypen

  • Notariell beglaubigte Verträge — unterschriebene und gestempelte Dokumente, die sich nicht ohne Verlust der Beweiskraft neu tippen lassen
  • Behördliche Urkunden — Geburts-, Heirats-, Studien- und Berufsurkunden von offiziellen Stellen
  • Gerichtsakten und Schriftsätze — historische Verfahrensakten und archivierte Urteile
  • Medizinische Unterlagen — Patientenakten, Laborbefunde und Überweisungen aus älteren Systemen
  • Finanzberichte — alte Kontoauszüge und Prüfberichte aus der Zeit vor der digitalen Archivierung
  • Technische Handbücher — Produktdokumentation von Herstellern, die nur Druckexemplare geliefert haben
Was passiert, wenn das gescannte Dokument auf dem Kopf steht oder gedreht ist?

Die OCR-Engine erkennt die Ausrichtung automatisch und korrigiert Drehungen von 0°, 90°, 180° und 270°. Moderate Schräglage (unter 10°) wird ebenfalls automatisch korrigiert.

Kann es Dokumente mit Stempeln und Wasserzeichen verarbeiten?

Ja. OCR filtert die meisten Standard-Wasserzeichen (heller diagonaler Text) und runde Stempel in Dokumenträndern. Text, der direkt mit einem dunklen Stempel überlappt, kann in diesem Bereich geringere Genauigkeit aufweisen.

Wird der ursprüngliche Scan in der Ausgabedatei beibehalten?

Die Ausgabe ist ein textbasiertes PDF mit dem übersetzten Inhalt im Original-Layout. Das Scan-Bild ist nicht eingebettet — das hält die Dateigröße klein und den Text durchsuchbar.

Gescanntes PDF jetzt übersetzen

Laden Sie ein beliebiges gescanntes Dokument hoch und lassen Sie OCR + KI die Arbeit erledigen. Kein Tippen, kein Kopieren.

Gescanntes PDF übersetzen