IA y Tecnología

Cómo traducir un PDF escaneado con OCR

sep. 21, 2026

Cómo traducir un PDF escaneado con OCR

El problema con los PDF escaneados

Cuando escaneas un documento en papel y lo guardas como PDF, el archivo contiene solo una imagen de la página — sin texto seleccionable ni copiable. Las herramientas de traducción habituales fallan completamente porque no hay nada que traducir: el texto existe solo como píxeles.

Esto afecta a una gran variedad de documentos: contratos notariados, certificados emitidos por organismos oficiales, registros históricos, impresiones de fax y cualquier documento que llegó en papel y fue digitalizado. En 2026, los documentos escaneados siguen representando una parte significativa de los archivos que las empresas necesitan traducir.

Cómo funciona OCR + traducción IA

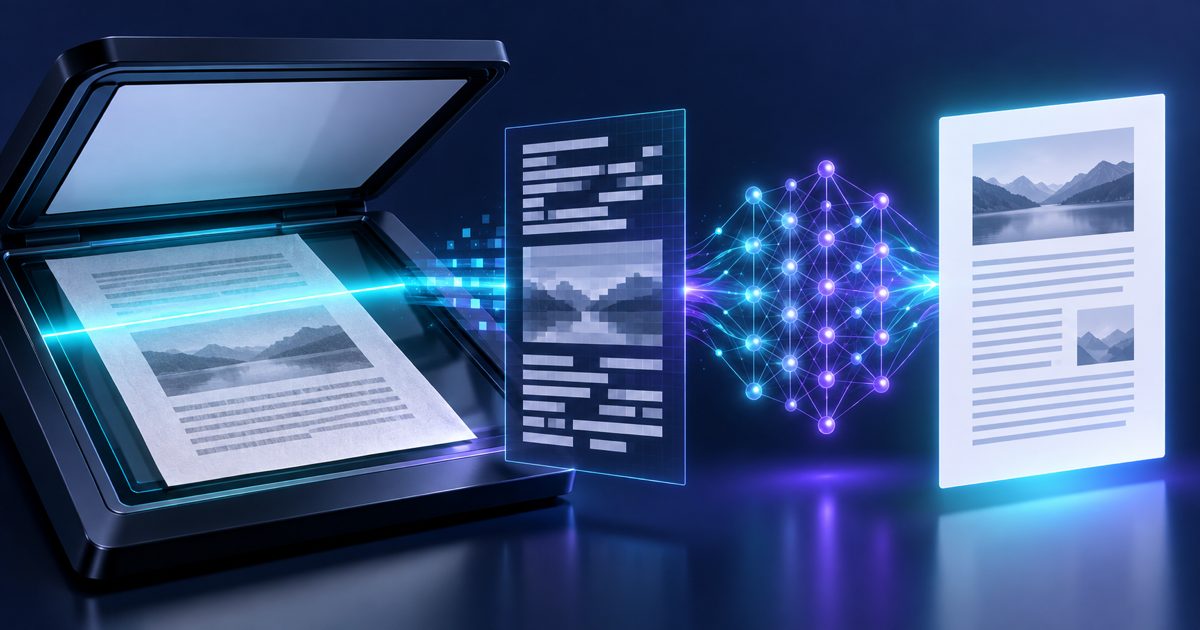
La solución es un proceso en dos fases: reconocimiento óptico de caracteres (OCR) y, a continuación, traducción automática neuronal.

  1. Análisis OCR — el motor escanea cada página píxel a píxel, identifica las formas de los caracteres y reconstruye la capa de texto.
  2. Detección de layout — se identifican columnas, tablas, encabezados y pies de página para reproducir la misma estructura en el resultado.
  3. Extracción de texto — el texto reconstruido se limpia: guiones de corte de línea, ruido y imperfecciones de escaneo se corrigen antes de la traducción.
  4. Traducción IA — el texto limpio se pasa a un modelo de traducción neuronal ajustado para contexto de documentos.
  5. Reconstrucción del formato — el texto traducido se coloca en la estructura original y se exporta como PDF.

Requisitos de calidad de imagen

La precisión del OCR depende directamente de la calidad del escaneo. Estas condiciones dan los mejores resultados:

  • Resolución — 300 DPI o superior. Por debajo de 100 DPI la precisión cae bruscamente.
  • Orientación — las páginas deben estar rectas. La corrección automática de inclinación funciona hasta ~10°.
  • Contraste — texto oscuro sobre fondo claro. La tinta desvanecida o los fondos de color reducen la precisión.
  • Sin escritura a mano — el texto impreso se reconoce con alta precisión; las anotaciones manuscritas se extraen donde son legibles.
  • Formato de archivo — PDF, JPG, PNG y TIFF son compatibles.
100+Scripts OCR
100+Idiomas destino
300DPI recomendados

Paso a paso: traduce tu PDF escaneado

  1. Sube el PDF escaneado — el sistema detecta automáticamente que es un documento basado en imagen.
  2. Selecciona el idioma de origen (opcional) — la detección automática funciona para la mayoría de scripts.
  3. Selecciona el idioma de destino — más de 100 idiomas disponibles.
  4. El OCR extrae el texto — se muestra una vista previa del contenido reconocido.
  5. La IA traduce — el texto extraído se traduce con el contexto completo del documento.
  6. Descarga el PDF traducido — el archivo de salida mantiene las mismas dimensiones y columnas que el escaneo original.

Tipos de documento escaneado más habituales

  • Contratos notariales: documentos firmados y sellados que no se pueden reescribir sin perder autenticidad
  • Certificados oficiales: partidas de nacimiento y matrimonio, títulos académicos y profesionales emitidos por organismos públicos
  • Expedientes judiciales y escritos: causas históricas y sentencias archivadas
  • Historiales médicos: fichas de paciente, resultados de laboratorio y volantes de derivación de sistemas antiguos
  • Estados financieros: extractos bancarios e informes de auditoría impresos antes del archivo digital
  • Manuales técnicos: documentación de producto de fabricantes que solo entregaron copias impresas
¿Qué pasa si el documento escaneado está boca abajo o girado?

El motor OCR aplica detección automática de orientación y corrige rotaciones de 0°, 90°, 180° y 270°. La inclinación moderada (menos de 10°) también se corrige automáticamente.

¿Puede manejar documentos con sellos y marcas de agua?

Sí. El OCR filtra la mayoría de marcas de agua estándar (texto diagonal claro) y sellos redondos en los márgenes. El texto que se superpone directamente con un sello oscuro puede tener menor precisión en esa zona.

¿Se conserva el escaneo original en el archivo de salida?

El resultado es un PDF basado en texto con el contenido traducido en el mismo layout. La imagen del escaneo no está incrustada, lo que mantiene el archivo pequeño y el texto buscable.

Traduce tu PDF escaneado ahora

Sube cualquier documento escaneado y deja que OCR + IA hagan el trabajo. Sin escribir, sin copiar.

Traducir PDF escaneado