जब आप किसी कागजी दस्तावेज़ को स्कैन करके PDF के रूप में सेव करते हैं, तो फ़ाइल में पेज की सिर्फ एक इमेज होती है — कोई ऐसा टेक्स्ट नहीं जिसे चुना या कॉपी किया जा सके। सामान्य अनुवाद टूल पूरी तरह विफल हो जाते हैं क्योंकि अनुवाद करने के लिए कुछ होता ही नहीं: टेक्स्ट केवल पिक्सल के रूप में मौजूद होता है।
यह समस्या दस्तावेज़ों की एक बड़ी रेंज को प्रभावित करती है: नोटरीकृत अनुबंध, सरकार द्वारा जारी प्रमाणपत्र, ऐतिहासिक रिकॉर्ड, फैक्स प्रिंटआउट, और कोई भी दस्तावेज़ जो कागज के रूप में आया और बाद में डिजिटाइज़ किया गया। 2026 में भी, स्कैन किए गए दस्तावेज़ उन फ़ाइलों का एक बड़ा हिस्सा हैं जिन्हें व्यवसायों को अनुवाद करना पड़ता है।
OCR + AI अनुवाद कैसे काम करता है
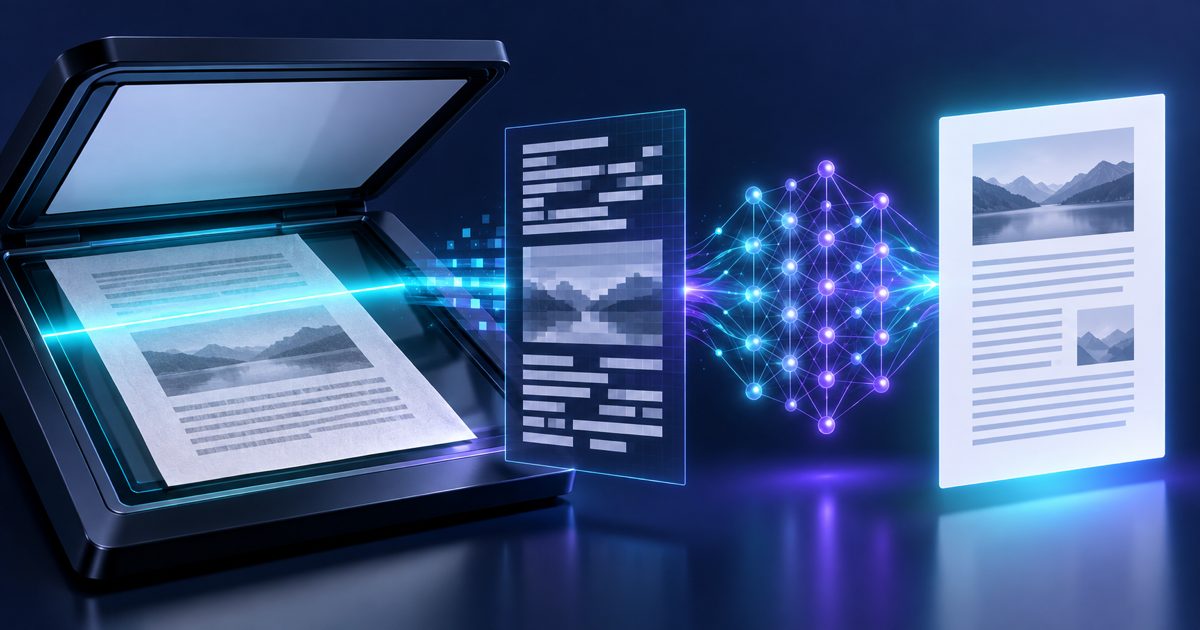
समाधान एक दो-चरणीय पाइपलाइन है: ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) के बाद न्यूरल मशीन ट्रांसलेशन।
OCR विश्लेषण — इंजन हर पेज को पिक्सल दर पिक्सल स्कैन करता है, कैरेक्टर के आकार पहचानता है, और टेक्स्ट लेयर को फिर से बनाता है। आधुनिक OCR लैटिन, अरबी, सिरिलिक, CJK (चीनी, जापानी, कोरियाई), देवनागरी सहित 100 से अधिक लिपियों को संभालता है।
लेआउट डिटेक्शन — कॉलम, टेबल, हेडर और फुटर की पहचान की जाती है और उन्हें मैप किया जाता है ताकि अनुवादित आउटपुट को उन्हीं ज़ोन में वापस रखा जा सके।
टेक्स्ट एक्सट्रैक्शन — फिर से बनाए गए टेक्स्ट को साफ किया जाता है: हाइफ़नेशन के अवशेष, लाइन-ब्रेक शोर, और स्कैनिंग की खामियों को अनुवाद से पहले ठीक किया जाता है।
AI अनुवाद — साफ किए गए टेक्स्ट को दस्तावेज़ के संदर्भ के लिए फाइन-ट्यून किए गए न्यूरल ट्रांसलेशन मॉडल में भेजा जाता है, जिससे पैराग्राफ और वाक्य की सीमाएं बरकरार रहती हैं।
फ़ॉर्मेट पुनर्निर्माण — अनुवादित टेक्स्ट को मूल दस्तावेज़ की संरचना में रखा जाता है और PDF के रूप में एक्सपोर्ट किया जाता है।
इमेज क्वालिटी की आवश्यकताएं
OCR की सटीकता सीधे स्कैन की गुणवत्ता पर निर्भर करती है। ये स्थितियां सबसे अच्छे परिणाम देती हैं:
रिज़ॉल्यूशन — 300 DPI या उससे अधिक। बड़े प्रिंट के लिए 150 DPI ठीक है; 100 DPI से नीचे सटीकता तेज़ी से गिरती है।
ओरिएंटेशन — पेज सीधे होने चाहिए। ऑटो-डिस्क्यू लगभग 10° तक के झुकाव को ठीक करता है लेकिन उससे ज़्यादा झुकाव नतीजों को खराब करता है।
कंट्रास्ट — हल्के बैकग्राउंड पर गहरा टेक्स्ट। फीकी स्याही, रंगीन कागज़ का बैकग्राउंड, या वॉटरमार्क सटीकता को कम करते हैं।
हाथ से लिखा हुआ नहीं — प्रिंटेड टेक्स्ट को उच्च सटीकता से पहचाना जाता है; हस्तलिखित टिप्पणियों को जहां पढ़ने योग्य हों वहां निकाला जाता है लेकिन अनिश्चित के रूप में फ्लैग किया जाता है।
फ़ाइल फ़ॉर्मेट — PDF, JPG, PNG, और TIFF सभी स्वीकार किए जाते हैं। मल्टी-पेज PDF को पेज दर पेज प्रोसेस किया जाता है।
100+OCR लिपियां
100+लक्षित भाषाएं
300अनुशंसित DPI
स्टेप-बाय-स्टेप: अपने स्कैन किए गए PDF का अनुवाद करें
स्कैन किए गए PDF को अपलोड करें — ड्रैग एंड ड्रॉप करें या फ़ाइल का URL पेस्ट करें। सिस्टम स्वचालित रूप से पहचान लेता है कि यह एक स्कैन (इमेज-आधारित) दस्तावेज़ है।
सोर्स लैंग्वेज चुनें (वैकल्पिक) — ऑटो-डिटेक्ट अधिकांश सामान्य लिपियों के लिए काम करता है। दुर्लभ भाषाओं या मिश्रित-लिपि वाले दस्तावेज़ों के लिए इसे मैन्युअली सेट करें।
टारगेट लैंग्वेज चुनें — 100 से अधिक भाषाएं उपलब्ध हैं।
OCR पहले चलता है — टेक्स्ट निकाला जाता है और पहचाने गए कंटेंट का एक पूर्वावलोकन दिखाया जाता है। आगे बढ़ने से पहले स्पष्ट त्रुटियों की जांच करें।
AI अनुवाद चलता है — निकाले गए टेक्स्ट का अनुवाद पूरे दस्तावेज़ के संदर्भ को बनाए रखते हुए किया जाता है।
अनुवादित PDF डाउनलोड करें — आउटपुट फ़ाइल में मूल स्कैन के समान पेज आयाम और कॉलम लेआउट होता है।
सामान्य स्कैन किए गए दस्तावेज़ों के प्रकार
नोटरीकृत अनुबंध — हस्ताक्षरित और मुहरबंद दस्तावेज़ जिन्हें फिर से टाइप नहीं किया जा सकता बिना प्रामाणिकता खोए
सरकार द्वारा जारी प्रमाणपत्र — आधिकारिक निकायों द्वारा जारी जन्म, विवाह, शैक्षणिक और व्यावसायिक प्रमाणपत्र
कोर्ट रिकॉर्ड और कानूनी दस्तावेज़ — ऐतिहासिक केस फ़ाइलें, संग्रहीत निर्णय
मेडिकल रिकॉर्ड — मरीज़ की फ़ाइलें, लैब रिपोर्ट, पुराने स्वास्थ्य सेवा सिस्टम से रेफ़रल पत्र
वित्तीय विवरण — पुराने बैंक स्टेटमेंट, डिजिटल आर्काइविंग से पहले प्रिंट किए गए ऑडिट रिपोर्ट
तकनीकी मैनुअल — उन निर्माताओं की उत्पाद डॉक्यूमेंटेशन जिन्होंने केवल प्रिंट कॉपी भेजी थीं
अगर स्कैन किया गया दस्तावेज़ उल्टा या घुमाया हुआ हो तो क्या होगा?
OCR इंजन स्वचालित रूप से ओरिएंटेशन का पता लगाता है और 0°, 90°, 180°, और 270° के रोटेशन को ठीक करता है। मध्यम झुकाव (10° से कम) को भी स्वचालित रूप से ठीक किया जाता है। बहुत ज़्यादा झुकी हुई पेजों के लिए, अपलोड करने से पहले किसी भी PDF व्यूअर में स्कैन को प्री-प्रोसेस करने से बेहतर परिणाम मिलेंगे।
क्या यह मुहर और वॉटरमार्क वाले स्कैन किए गए दस्तावेज़ों को संभाल सकता है?
हां। OCR ज़्यादातर स्टैंडर्ड वॉटरमार्क (हल्का डायगनल टेक्स्ट) और दस्तावेज़ के मार्जिन में लगी गोल मुहरों को फ़िल्टर कर देता है। जो टेक्स्ट सीधे किसी गहरी मुहर से ओवरलैप करता है उस क्षेत्र में सटीकता कम हो सकती है।
क्या आउटपुट में मूल स्कैन को सुरक्षित रखा जाता है?
आउटपुट एक टेक्स्ट-आधारित PDF होता है जिसमें अनुवादित कंटेंट मूल पेज संरचना से मेल खाने के लिए लेआउट किया गया होता है। रॉ स्कैन इमेज एम्बेड नहीं की जाती — इससे फ़ाइल का आकार छोटा रहता है और टेक्स्ट सर्च करने योग्य बना रहता है। अगर आपको अनुवाद के साथ स्कैन की गई इमेज भी चाहिए, तो बाइलिंगुअल एक्सपोर्ट का अनुरोध करें।
अभी अपने स्कैन किए गए PDF का अनुवाद करें
कोई भी स्कैन किया गया दस्तावेज़ अपलोड करें और बाकी काम OCR + AI को करने दें। कोई टाइपिंग नहीं, कोई कॉपी नहीं — बस सेकंडों में सटीक अनुवाद।
प्रेजेंटेशन अनुवाद की असली चुनौती
एक PowerPoint प्रेजेंटेशन सिर्फ़ टेक्स्ट से कहीं अधिक है। हर स्लाइड एक बारीकी से डिज़…
Amanda Lee
क्या आप अपनी फ़ाइल संसाधित करने के लिए तैयार हैं?
हमारे AI टूल का तुरंत उपयोग शुरू करने के लिए अपना दस्तावेज़ अपलोड करें।
अपनी फ़ाइल यहां छोड़ेंया अपने डिवाइस से ब्राउज़ करने के लिए क्लिक करें
फ़ाइल संसाधित हो रही है...
फ़ाइल प्रसंस्करण के लिए तैयार है!
अपने परिणाम डाउनलोड करने के लिए मुफ़्त खाता बनाएं - इसमें एक मिनट से भी कम समय लगता है और आपकी फ़ाइलों तक पहुंच केवल आपके पास होती है। मुफ़्त प्लान शामिल, क्रेडिट कार्ड की आवश्यकता नहीं।
हम आपके ब्राउज़िंग अनुभव को बेहतर बनाने और अपने ट्रैफ़िक का विश्लेषण करने के लिए कुकीज़ का उपयोग करते हैं। "सभी स्वीकार करें" पर क्लिक करके आप कुकीज़ के हमारे उपयोग के लिए सहमति देते हैं।
हमारी कुकी नीति पढ़ें
कुकी सेटिंग्स
अपनी कुकी प्राथमिकताएँ प्रबंधित करें। आप नीचे विभिन्न प्रकार की कुकीज़ को सक्षम या अक्षम कर सकते हैं।