IA & Tecnologia

Como traduzir um PDF digitalizado com OCR

set 21, 2026

Como traduzir um PDF digitalizado com OCR

O problema com os PDF digitalizados

Quando digitalizas um documento em papel e o guardas como PDF, o ficheiro contém apenas uma imagem da página — sem texto selecionável ou copiável. As ferramentas de tradução convencionais falham completamente porque não há nada para traduzir: o texto existe apenas como píxeis.

Isto afeta uma grande variedade de documentos: contratos notariais, certidões emitidas por entidades oficiais, registos históricos, impressões de fax e qualquer documento que chegou em papel e foi digitalizado. Em 2026, os documentos digitalizados continuam a representar uma parte significativa dos ficheiros que as empresas precisam de traduzir.

Como funciona o OCR + tradução por IA

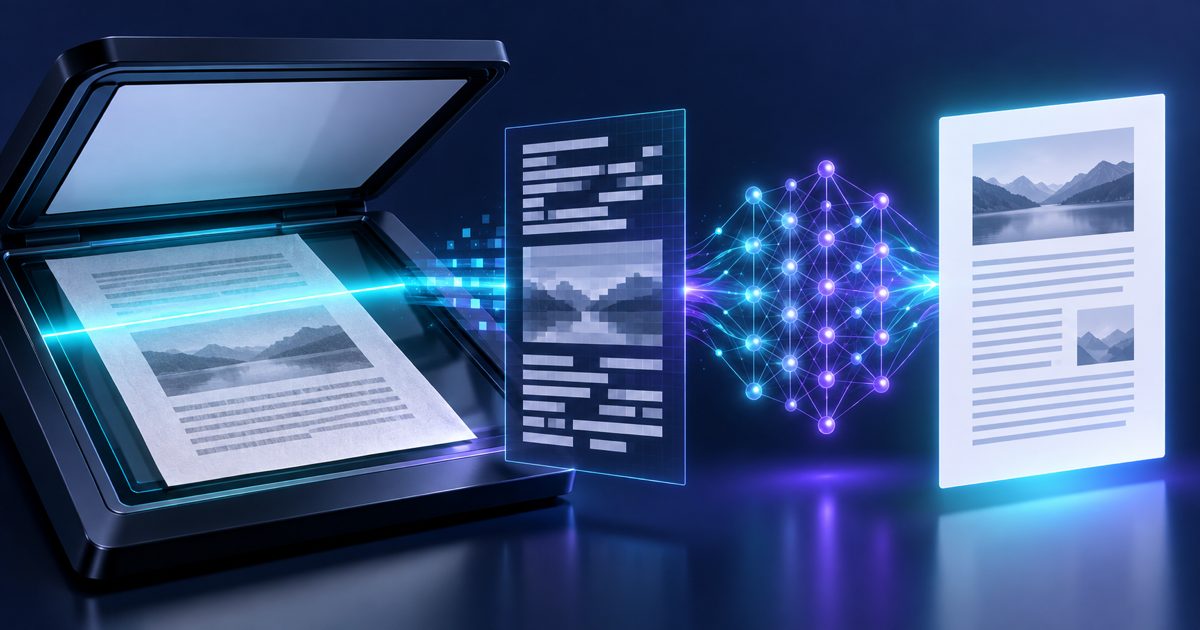
A solução é um processo em duas fases: reconhecimento ótico de carateres (OCR) e, em seguida, tradução automática neuronal.

  1. Análise OCR — o motor examina cada página píxel a píxel, identifica as formas dos caracteres e reconstrói a camada de texto.
  2. Deteção de layout — colunas, tabelas, cabeçalhos e rodapés são identificados e mapeados.
  3. Extração de texto — o texto reconstruído é limpo: hífenes de quebra de linha, ruído e imperfeições de digitalização são corrigidos antes da tradução.
  4. Tradução por IA — o texto limpo é passado para um modelo de tradução neuronal ajustado para contexto de documentos.
  5. Reconstrução do formato — o texto traduzido é colocado na estrutura original e exportado como PDF.

Requisitos de qualidade de imagem

A exatidão do OCR depende diretamente da qualidade da digitalização. Estas condições dão os melhores resultados:

  • Resolução — 300 DPI ou superior. Abaixo de 100 DPI a precisão cai acentuadamente.
  • Orientação — as páginas devem estar direitas. A correção automática de inclinação funciona até ~10°.
  • Contraste — texto escuro sobre fundo claro. Tinta desbotada ou fundos coloridos reduzem a precisão.
  • Sem escrita manual — o texto impresso é reconhecido com alta precisão; as anotações manuscritas são extraídas onde legíveis.
  • Formato de ficheiro — PDF, JPG, PNG e TIFF são aceites.
100+Scripts OCR
100+Idiomas destino
300DPI recomendados

Passo a passo: traduz o teu PDF digitalizado

  1. Carrega o PDF digitalizado — o sistema deteta automaticamente que é um documento baseado em imagem.
  2. Seleciona o idioma de origem (opcional) — a deteção automática funciona para a maioria dos scripts.
  3. Seleciona o idioma de destino — mais de 100 idiomas disponíveis.
  4. O OCR extrai o texto — é mostrada uma pré-visualização do conteúdo reconhecido.
  5. A IA traduz — o texto extraído é traduzido com o contexto completo do documento.
  6. Transfere o PDF traduzido — o ficheiro de saída mantém as mesmas dimensões e colunas do scan original.

Tipos de documento digitalizado mais frequentes

  • Contratos notariais — documentos assinados e carimbados que não podem ser reescritos sem perder autenticidade
  • Certidões oficiais — certidões de nascimento e casamento, diplomas académicos e títulos profissionais emitidos por organismos públicos
  • Processos e peças judiciais — processos antigos e sentenças arquivadas
  • Registos clínicos — fichas de doente, resultados de laboratório e cartas de referenciação de sistemas antigos
  • Demonstrações financeiras — extratos bancários e relatórios de auditoria impressos antes do arquivo digital
  • Manuais técnicos — documentação de produto de fabricantes que só forneceram exemplares em papel
E se o documento digitalizado estiver de cabeça para baixo ou rodado?

O motor OCR aplica deteção automática de orientação e corrige rotações de 0°, 90°, 180° e 270°. A inclinação moderada (menos de 10°) também é corrigida automaticamente.

Consegue lidar com documentos com selos e marcas de água?

Sim. O OCR filtra a maioria das marcas de água padrão (texto diagonal claro) e selos redondos nas margens. O texto que se sobrepõe diretamente a um selo escuro pode ter menor precisão nessa zona.

O scan original é preservado no ficheiro de saída?

O resultado é um PDF baseado em texto com o conteúdo traduzido no mesmo layout. A imagem do scan não está incorporada, o que mantém o ficheiro pequeno e o texto pesquisável.

Traduz o teu PDF digitalizado agora

Carrega qualquer documento digitalizado e deixa o OCR + IA fazer o resto. Sem digitar, sem copiar.

Traduzir PDF digitalizado