AI 및 기술

OCR로 스캔한 PDF 번역하는 방법

9월 21, 2026

OCR로 스캔한 PDF 번역하는 방법

스캔한 PDF의 문제점

종이 문서를 스캔해 PDF로 저장하면 파일에는 페이지의 이미지만 포함됩니다 — 선택하거나 복사할 수 있는 텍스트는 없습니다. 텍스트가 픽셀로만 존재하기 때문에 일반적인 번역 도구는 완전히 작동하지 않습니다.

이는 공증된 계약서, 정부 발급 증명서, 역사적 기록물, 팩스 출력물, 그리고 종이로 도착한 뒤 디지털화된 모든 문서 등 매우 다양한 문서에 영향을 미칩니다. 2026년에도 스캔 문서는 기업이 번역해야 하는 파일에서 여전히 상당한 비중을 차지합니다.

OCR + AI 번역의 작동 방식

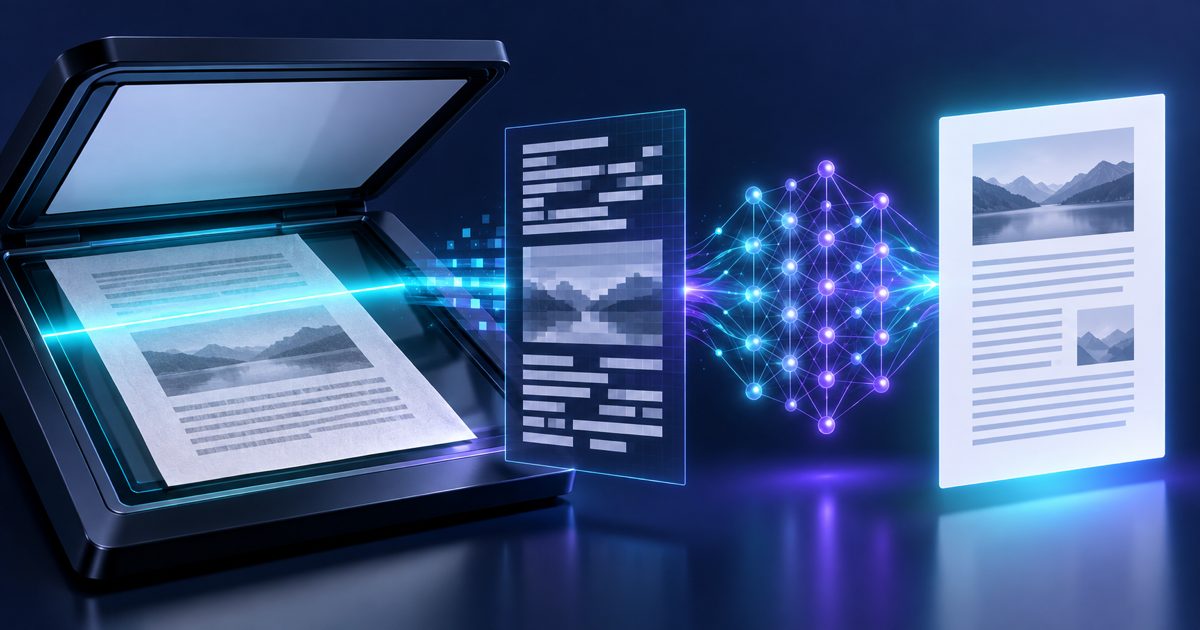
해결책은 2단계 파이프라인입니다. 광학 문자 인식(OCR)에 이어 신경망 기계 번역이 진행됩니다.

  1. OCR 분석 — 엔진이 각 페이지를 픽셀 단위로 스캔하고 문자 모양을 식별해 텍스트 레이어를 재구성합니다. 최신 OCR은 라틴, 아랍, 키릴, CJK(중국어, 일본어, 한국어), 데바나가리 등 100개 이상의 문자 체계를 지원합니다.
  2. 레이아웃 감지 — 열, 표, 머리글, 바닥글을 식별하고 매핑해 번역된 결과가 동일한 위치에 배치될 수 있도록 합니다.
  3. 텍스트 추출 — 재구성된 텍스트를 정리합니다. 하이픈 흔적, 줄바꿈 노이즈, 스캔 결함이 번역 전에 수정됩니다.
  4. AI 번역 — 정리된 텍스트는 문서 맥락에 맞게 조정된 신경망 번역 모델로 전달되어 단락과 문장 경계가 보존됩니다.
  5. 형식 재구성 — 번역된 텍스트가 원본 문서 구조에 배치되어 PDF로 내보내집니다.

이미지 품질 요건

OCR 정확도는 스캔 품질에 직접적으로 좌우됩니다. 다음 조건에서 가장 좋은 결과를 얻을 수 있습니다.

  • 해상도 — 300 DPI 이상. 150 DPI는 큰 활자에는 괜찮지만 100 DPI 미만에서는 정확도가 급격히 떨어집니다.
  • 방향 — 페이지가 똑바로 되어 있어야 합니다. 자동 기울기 보정은 약 10°까지의 기울기를 보정하지만 그보다 큰 기울기는 결과를 저하시킵니다.
  • 대비 — 밝은 배경에 어두운 텍스트. 흐릿해진 잉크, 컬러 배경, 워터마크는 정확도를 떨어뜨립니다.
  • 손글씨 불가 — 인쇄된 텍스트는 높은 정확도로 인식되며, 손글씨 주석은 읽을 수 있는 경우에만 추출되고 불확실한 것으로 표시됩니다.
  • 파일 형식 — PDF, JPG, PNG, TIFF가 모두 지원됩니다. 여러 페이지의 PDF는 페이지별로 처리됩니다.
100+OCR 문자 체계
100+번역 대상 언어
300권장 DPI

단계별 안내: 스캔한 PDF 번역하기

  1. 스캔한 PDF 업로드 — 파일을 드래그 앤 드롭하거나 파일 URL을 붙여넣으세요. 시스템이 스캔된(이미지 기반) 문서임을 자동으로 감지합니다.
  2. 원본 언어 선택(선택 사항) — 대부분의 일반적인 문자 체계에서는 자동 감지가 작동합니다. 드문 언어나 문자 체계가 혼합된 문서는 수동으로 설정하세요.
  3. 대상 언어 선택 — 100개 이상의 언어를 사용할 수 있습니다.
  4. 먼저 OCR이 실행됩니다 — 텍스트가 추출되고 인식된 콘텐츠의 미리보기가 표시됩니다. 진행하기 전에 명백한 오류가 없는지 확인하세요.
  5. AI 번역이 실행됩니다 — 문서 전체 맥락을 유지한 채 추출된 텍스트가 번역됩니다.
  6. 번역된 PDF 다운로드 — 출력 파일은 원본 스캔과 동일한 페이지 크기와 열 레이아웃을 유지합니다.

자주 접하는 스캔 문서 유형

  • 공증된 계약서 — 서명하고 날인된 문서로, 다시 입력하면 진본성을 잃게 되는 문서
  • 정부 발급 증명서 — 공식 기관에서 발급한 출생, 혼인, 학력, 전문 자격 증명서
  • 법원 기록 및 법률 서류 — 과거 사건 파일, 보관된 판결문
  • 의료 기록 — 환자 파일, 검사 보고서, 구형 의료 시스템의 진료 의뢰서
  • 재무제표 — 오래된 은행 명세서, 디지털 보관 이전에 인쇄된 감사 보고서
  • 기술 매뉴얼 — 인쇄본만 제공했던 제조사의 제품 문서
스캔한 문서가 뒤집혀 있거나 회전되어 있으면 어떻게 되나요?

OCR 엔진은 자동으로 방향을 감지하고 0°, 90°, 180°, 270° 회전을 보정합니다. 완만한 기울기(10° 미만)도 자동으로 보정됩니다. 심하게 기울어진 페이지의 경우, 업로드 전에 PDF 뷰어에서 스캔을 사전 처리하면 더 나은 결과를 얻을 수 있습니다.

도장이나 워터마크가 있는 스캔 문서도 처리할 수 있나요?

네. OCR은 대부분의 표준 워터마크(연한 대각선 텍스트)와 문서 여백에 있는 원형 도장을 필터링합니다. 어두운 도장과 직접 겹치는 텍스트는 해당 영역의 정확도가 낮아질 수 있습니다.

출력물에 원본 스캔이 보존되나요?

출력물은 원본 페이지 구조에 맞춰 배치된 번역 콘텐츠가 포함된 텍스트 기반 PDF입니다. 원본 스캔 이미지는 포함되지 않습니다 — 이를 통해 파일 크기를 작게 유지하고 텍스트를 검색 가능하게 만듭니다. 번역과 함께 스캔 이미지가 필요하면 이중 언어 내보내기를 요청하세요.

지금 스캔한 PDF 번역하기

스캔한 문서를 업로드하기만 하면 나머지는 OCR + AI가 처리합니다. 입력도, 복사도 필요 없이 몇 초 만에 정확한 번역을 받아보세요.

스캔 PDF 번역하기
타임스탬프를 유지하며 SRT 자막을 번역하는 방법featured image

AI 및 기술

타임스탬프를 유지하며 SRT 자막을 번역하는 방법

자막 번역이 정밀함을 요구하는 이유 SRT 파일은 매우 엄격하게 구조화된 형식입니다. 각 자막 블록에는 순서 번호, 타임스탬프 범위(시작 → 끝), 그리고 한두 줄의 텍스트가 포함됩니다. 타임스탬프를 건드리지 않고…

Amanda Lee의 프로필 사진

Amanda Lee

온라인에서 PowerPoint 프레젠테이션을 번역하는 방법featured image

AI 및 기술

온라인에서 PowerPoint 프레젠테이션을 번역하는 방법

프레젠테이션 번역의 진짜 어려움 PowerPoint 프레젠테이션은 단순한 텍스트 그 이상입니다. 모든 슬라이드는 정교하게 설계된 캔버스로, 텍스트 상자는 시각적 균형을 위해 배치되고 글꼴 크기는 위계를 만들어냅니다…

Amanda Lee의 프로필 사진

Amanda Lee