Quando scansioni un documento cartaceo e lo salvi come PDF, il file contiene solo un'immagine della pagina — senza testo selezionabile o copiabile. Gli strumenti di traduzione tradizionali falliscono completamente perché non c'è nulla da tradurre: il testo esiste solo come pixel.
Questo riguarda una vasta gamma di documenti: contratti notarili, certificati rilasciati da enti governativi, registri storici, stampe di fax e qualsiasi documento arrivato su carta e poi digitalizzato. Nel 2026, i documenti scansionati rappresentano ancora una quota significativa dei file che le aziende devono tradurre.
Come funzionano OCR + traduzione IA
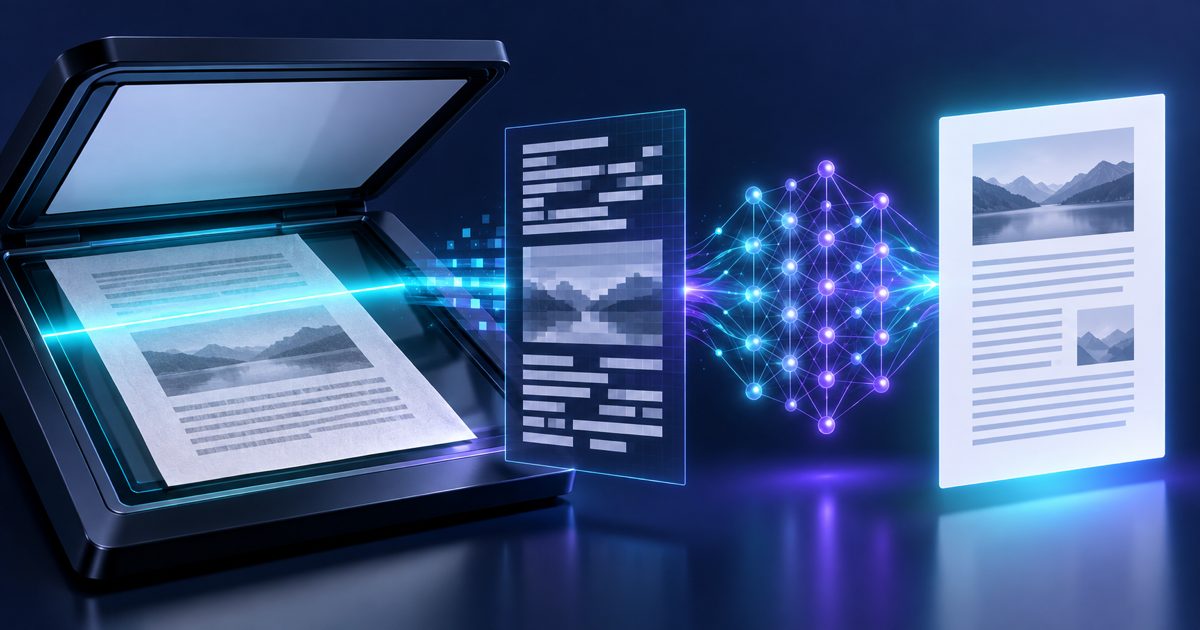
La soluzione è una pipeline in due fasi: riconoscimento ottico dei caratteri (OCR) seguito dalla traduzione automatica neurale.
Analisi OCR — il motore scansiona ogni pagina pixel per pixel, identifica le forme dei caratteri e ricostruisce il livello di testo. L'OCR moderno gestisce oltre 100 alfabeti, tra cui latino, arabo, cirillico, CJK (cinese, giapponese, coreano), devanagari e altri.
Rilevamento del layout — colonne, tabelle, intestazioni e piè di pagina vengono identificati e mappati in modo che il risultato tradotto possa essere collocato nelle stesse zone.
Estrazione del testo — il testo ricostruito viene ripulito: artefatti di sillabazione, rumore da interruzione di riga e imperfezioni di scansione vengono corretti prima della traduzione.
Traduzione IA — il testo pulito viene passato a un modello di traduzione neurale ottimizzato per il contesto documentale, preservando i confini di paragrafi e frasi.
Ricostruzione del formato — il testo tradotto viene impaginato nella struttura originale del documento ed esportato come PDF.
Requisiti di qualità dell'immagine
L'accuratezza dell'OCR dipende direttamente dalla qualità della scansione. Queste condizioni offrono i risultati migliori:
Risoluzione — 300 DPI o superiore. 150 DPI è accettabile per stampe grandi; sotto i 100 DPI l'accuratezza cala bruscamente.
Orientamento — le pagine devono essere diritte. La correzione automatica dell'inclinazione corregge fino a ~10° di rotazione, ma inclinazioni maggiori peggiorano i risultati.
Contrasto — testo scuro su sfondo chiaro. Inchiostro sbiadito, sfondi colorati o filigrane riducono l'accuratezza.
Nessuna scrittura a mano — il testo stampato viene riconosciuto con alta precisione; le annotazioni manoscritte vengono estratte dove leggibili ma segnalate come incerte.
Formato file — PDF, JPG, PNG e TIFF sono tutti accettati. I PDF multipagina vengono elaborati pagina per pagina.
100+Alfabeti OCR
100+Lingue di destinazione
300DPI consigliati
Passo dopo passo: traduci il tuo PDF scansionato
Carica il PDF scansionato — trascina e rilascia oppure incolla l'URL del file. Il sistema rileva automaticamente che si tratta di un documento scansionato (basato su immagine).
Seleziona la lingua di origine (opzionale) — il rilevamento automatico funziona per la maggior parte degli alfabeti comuni. Impostala manualmente per lingue rare o documenti con alfabeti misti.
Seleziona la lingua di destinazione — oltre 100 lingue disponibili.
L'OCR viene eseguito per primo — il testo viene estratto e viene mostrata un'anteprima del contenuto riconosciuto. Controlla eventuali errori evidenti prima di procedere.
Viene eseguita la traduzione IA — il testo estratto viene tradotto mantenendo l'intero contesto del documento.
Scarica il PDF tradotto — il file di output ha le stesse dimensioni di pagina e lo stesso layout a colonne della scansione originale.
Tipi comuni di documenti scansionati
Contratti notarili — documenti firmati e timbrati che non possono essere ridigitati senza perdere autenticità
Certificati rilasciati da enti governativi — certificati di nascita, matrimonio, accademici e professionali rilasciati da organismi ufficiali
Atti giudiziari e documenti legali — fascicoli di casi storici, sentenze archiviate
Cartelle cliniche — fascicoli pazienti, referti di laboratorio, lettere di consulto da sistemi sanitari più datati
Bilanci e rendiconti finanziari — estratti conto bancari storici, rapporti di audit stampati prima dell'archiviazione digitale
Manuali tecnici — documentazione di prodotto di produttori che distribuivano solo copie cartacee
Cosa succede se il documento scansionato è capovolto o ruotato?
Il motore OCR applica il rilevamento automatico dell'orientamento e corregge rotazioni di 0°, 90°, 180° e 270°. Anche un'inclinazione moderata (inferiore a 10°) viene corretta automaticamente. Per pagine molto inclinate, pre-elaborare la scansione in un qualsiasi lettore PDF prima del caricamento darà risultati migliori.
Riesce a gestire documenti scansionati con timbri e filigrane?
Sì. L'OCR filtra la maggior parte delle filigrane standard (testo diagonale chiaro) e i timbri rotondi posizionati nei margini del documento. Il testo che si sovrappone direttamente a un timbro scuro può avere un'accuratezza ridotta nell'area interessata.
La scansione originale viene conservata nell'output?
L'output è un PDF basato su testo con il contenuto tradotto impaginato per rispecchiare la struttura originale della pagina. L'immagine grezza della scansione non viene incorporata — questo mantiene ridotte le dimensioni del file e il testo ricercabile. Se hai bisogno dell'immagine scansionata insieme alla traduzione, richiedi un'esportazione bilingue.
Traduci ora il tuo PDF scansionato
Carica qualsiasi documento scansionato e lascia che OCR + IA facciano il resto. Niente digitazione, niente copia-incolla — solo una traduzione accurata in pochi secondi.
La vera sfida della traduzione di una presentazione
Una presentazione PowerPoint è più di un semplice testo. Ogni diapo…
Amanda Lee
Pronto a Elaborare il Tuo File?
Carica il tuo documento per iniziare a usare i nostri strumenti di IA all'istante.
Trascina qui il tuo fileo clicca per sfogliare dal tuo dispositivo
Elaborazione file...
File pronto per l'elaborazione!
Crea un account gratuito per scaricare i risultati - richiede meno di un minuto e solo tu puoi accedere ai tuoi file. Piano gratuito incluso, nessuna carta di credito richiesta.
Utilizziamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. Cliccando su "Accetta Tutto" acconsenti all'uso dei cookie.
Leggi la nostra Informativa sui Cookie
Impostazioni Cookie
Gestisci le tue preferenze sui cookie. Puoi abilitare o disabilitare diversi tipi di cookie qui sotto.